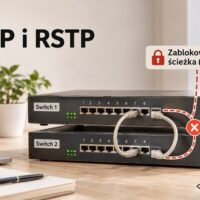
Wystarczy jeden przewód Ethernet wpięty przypadkowo do dwóch portów tego samego przełącznika, żeby sieć w biurze przestała odpowiadać. Komputery tracą dostęp do internetu, telefony VoIP przerywają rozmowy, a systemy magazynowe zgłaszają błędy połączenia. Diody na switchu migają niemal bez przerwy, chociaż użytkownicy nie wykonują żadnych szczególnie wymagających operacji. Przyczyną może być pętla sieciowa, która wywołała lawinowy wzrost liczby ramek Ethernet.
Takiej awarii nie musi powodować uszkodzony sprzęt. Czasami wystarczy nieprawidłowo podłączony kabel albo dodatkowy switch ustawiony przez pracownika pod biurkiem. Przed skutkami podobnych pomyłek chronią mechanizmy STP (Spanning Tree Protocol) i RSTP (Rapid Spanning Tree Protocol). Ich prawidłowa konfiguracja decyduje o tym, czy nadmiarowe połączenie zapewni ciągłość pracy, czy stanie się przyczyną awarii całej sieci lokalnej.
Czym jest pętla sieciowa i dlaczego powstaje burza broadcastowa?
W sieci Ethernet przełączniki przekazują ramki na podstawie adresów MAC. Jeżeli urządzenie nie zna portu prowadzącego do docelowego adresu, rozsyła ramkę przez pozostałe odpowiednie porty w danym VLAN-ie. Podobnie traktuje ramki rozgłoszeniowe, czyli broadcast, wykorzystywane między innymi przez ARP do odnajdywania adresu MAC odpowiadającego adresowi IPv4.
Problem zaczyna się wtedy, gdy w topologii warstwy drugiej istnieje zamknięta ścieżka, po której ramki mogą krążyć bez końca.
W przeciwieństwie do pakietów IP standardowe ramki Ethernet nie mają pola TTL, które ograniczałoby liczbę przeskoków. Jeżeli przełączniki nie zablokują nadmiarowej ścieżki, ramka może być wielokrotnie przekazywana i kopiowana.
Praktyczny przykład: w niewielkiej firmie działają dwa 24-portowe switche połączone przewodem o przepustowości 1 Gb/s. Technik dokłada drugi kabel, chcąc zwiększyć przepustowość między urządzeniami. Nie konfiguruje jednak agregacji łączy LACP ani nie sprawdza działania STP.
Powstają dwie równoległe ścieżki. Ramki rozgłoszeniowe wysyłane przez jeden przełącznik trafiają do drugiego i wracają pierwszym lub drugim połączeniem. Kolejne kopie są ponownie rozsyłane. W krótkim czasie pojawiają się trzy problemy:
- Burza broadcastowa – ramki rozgłoszeniowe zajmują coraz większą część przepustowości łączy i obciążają urządzenia końcowe.
- Niestabilność tablic MAC – ten sam adres źródłowy jest widoczny naprzemiennie na różnych portach, co powoduje tzw. MAC flapping.
- Przeciążenie przełączników – rośnie liczba przetwarzanych ramek, mogą zapełniać się bufory, a legalny ruch jest opóźniany lub odrzucany.
Awaria nie musi ograniczać się do dwóch połączonych switchy. Jeżeli pętla występuje w VLAN-ie rozciągniętym na kilka pięter budynku, jej skutki mogą dotknąć wszystkich urządzeń korzystających z tej samej domeny rozgłoszeniowej.
Czy rozwiązaniem jest ograniczenie broadcastów? Mechanizm storm control pozwala ustawić próg ruchu rozgłoszeniowego na porcie, przykładowo jako procent przepustowości lub liczbę pakietów na sekundę. Może zmniejszyć skutki awarii, ale nie zastępuje STP. Pętla obejmuje również ruch multicast i unknown unicast, a zbyt niski próg może zakłócić poprawne działanie usług sieciowych.
Podział na VLAN-y ogranicza zasięg części problemów, lecz nie usuwa pętli w obrębie danego VLAN-u. Najpierw trzeba wyeliminować niekontrolowane ścieżki warstwy drugiej, a dopiero później dobierać dodatkowe ograniczenia ruchu.
Jak działają STP oraz RSTP i który protokół wybrać?
STP, opisany historycznie w IEEE 802.1D, pozwala zachować fizycznie nadmiarowe połączenia między przełącznikami, ale tworzy logiczną topologię bez pętli. Urządzenia wymieniają komunikaty BPDU (Bridge Protocol Data Unit) i ustalają, które porty mogą przekazywać ruch.
Pierwszym etapem jest wybór przełącznika nadrzędnego, czyli Root Bridge. Zostaje nim urządzenie z najniższym identyfikatorem Bridge ID, uwzględniającym priorytet i adres MAC oraz, w odpowiednich implementacjach, identyfikator systemowy powiązany z VLAN-em.
Następnie przełączniki obliczają koszt ścieżek prowadzących do Root Bridge. Na tej podstawie wybierają porty potrzebne do komunikacji, a nadmiarowe przejścia blokują.
W klasycznym STP istotne są trzy domyślne parametry:
- Hello Time: 2 sekundy – standardowy odstęp między komunikatami BPDU generowanymi przez Root Bridge.
- Forward Delay: 15 sekund – czas przewidziany dla każdego z przejściowych stanów Listening i Learning.
- Max Age: 20 sekund – domyślny czas ważności informacji o topologii STP.
Przy typowych warunkach przejście portu przez Listening i Learning trwa około 30 sekund. W niektórych scenariuszach awarii konwergencja klasycznego STP może wymagać około 50 sekund. Nie jest to jednak stały czas każdej rekonfiguracji.
W sieci biurowej kilkadziesiąt sekund bez komunikacji oznacza przerwane sesje z serwerem, problemy z telefonią IP i opóźnienia aplikacji korzystających z baz danych.
RSTP, opracowany jako IEEE 802.1w i później włączony do IEEE 802.1Q, skraca ten proces. Zamiast opierać zmianę topologii wyłącznie na oczekiwaniu na upływ timerów, wykorzystuje między innymi wymianę komunikatów Proposal/Agreement oraz role portów Root, Designated, Alternate i Backup.
RSTP posługuje się trzema stanami portów: Discarding, Learning i Forwarding. Na zgodnym łączu punkt-punkt między przełącznikami może bardzo szybko aktywować przygotowaną wcześniej alternatywną ścieżkę.
Załóżmy, że firma ma dwa przełączniki dystrybucyjne i kilka przełączników dostępowych. Każdy switch dostępowy posiada dwa uplinki. Jeden prowadzi aktywnie ruch, drugi pozostaje ścieżką zapasową. Po zerwaniu aktywnego kabla RSTP może przełączyć komunikację na zapasowy uplink w czasie rzędu sekund, w sprzyjających warunkach nawet szybciej.
Nie jest to gwarancja konkretnego czasu odtworzenia połączenia. Wynik zależy między innymi od rodzaju awarii, zgodności protokołów, topologii i sposobu wykrycia utraty łącza. Połączenie z urządzeniem obsługującym wyłącznie klasyczne STP może ograniczać szybkość konwergencji.
W nowych instalacjach Ethernet RSTP jest zazwyczaj rozsądniejszym wyborem niż klasyczny STP. Nie oznacza to jednak, że należy bez sprawdzenia przełączyć wszystkie urządzenia na jeden tryb. W środowisku wieloproducentowym trzeba potwierdzić obsługiwane standardy, sposób działania STP dla VLAN-ów i zgodność konfiguracji.
Istotny jest także wybór Root Bridge. W firmowej sieci najlepiej świadomie wskazać przełącznik dystrybucyjny lub rdzeniowy, ustawiając odpowiedni priorytet, zamiast pozwalać, aby o wyniku wyboru przesądzały przypadkowe wartości adresów MAC. Dla wielu implementacji typowa domyślna wartość priorytetu wynosi 32768, a konfiguracja odbywa się krokami po 4096.
Zabezpieczanie portów i diagnozowanie pętli w działającej sieci
Samo uruchomienie RSTP nie wystarcza. Najwięcej problemów pojawia się na portach dostępowych, do których użytkownicy podłączają komputery, drukarki, telefony IP, małe przełączniki i inne urządzenia.
Pierwszym zabezpieczeniem jest prawidłowe rozróżnienie portów końcowych od połączeń między przełącznikami.
Port edge, określany w urządzeniach Cisco także przez funkcję PortFast, umożliwia szybkie rozpoczęcie przekazywania ruchu przez urządzenie końcowe. Nie wymaga oczekiwania na standardowe etapy konwergencji STP.
Takie ustawienie ma sens na porcie komputera lub drukarki. Nie powinno być bezrefleksyjnie stosowane do uplinku między switchami, ponieważ port zaczynający natychmiast przekazywać ramki może chwilowo dopuścić niepożądaną ścieżkę.
Drugim zabezpieczeniem jest BPDU Guard. Gdy port przeznaczony dla urządzenia końcowego otrzyma komunikat BPDU, mechanizm wyłącza port lub blokuje go zgodnie z implementacją producenta.
Przykład: pracownik podłącza do gniazda biurowego własny zarządzalny switch wysyłający BPDU. Prawidłowo skonfigurowany BPDU Guard odcina port dostępowy, chroniąc resztę infrastruktury przed nieautoryzowanym udziałem urządzenia w topologii STP.
Trzeba jednak znać ograniczenie: BPDU Guard nie wykryje każdej pętli. Jeżeli dwa porty zostaną połączone przez prosty niezarządzalny switch, który nie przekazuje BPDU, mechanizm może nie zadziałać. Dlatego w miejscach narażonych na takie połączenia przydaje się dodatkowa funkcja loop detection lub loop protection, o ile konkretny model ją obsługuje.
W rozbudowanej sieci stosuje się też:
- Root Guard – zabezpiecza wybrane porty przed przyjęciem lepszych informacji BPDU, które mogłyby zmienić Root Bridge.
- Loop Guard – ogranicza ryzyko nieprawidłowego odblokowania portu, który przestał otrzymywać oczekiwane BPDU.
- Storm Control – ogranicza natężenie wybranych kategorii ruchu na porcie.
- Monitoring SNMP i syslog – ułatwia wykrywanie zmian topologii, blokad portów i skoków wykorzystania interfejsów.
Każde zabezpieczenie ma własny zakres zastosowania. Przykładowo Root Guard nie powinien być aktywowany bez analizy na porcie, przez który switch prawidłowo komunikuje się z nadrzędnym Root Bridge.
Jak zdiagnozować podejrzenie pętli?
W pierwszej kolejności należy sprawdzić liczniki ruchu na interfejsach i logi przełączników. Niepokojące są nagłe wzrosty liczby broadcastów, wielokrotne zmiany lokalizacji tego samego adresu MAC oraz częste zdarzenia zmiany topologii STP.
Na przełącznikach Cisco IOS pomocne są między innymi polecenia show spanning-tree, show spanning-tree detail, show interfaces counters i show mac address-table. Dostępność oraz składnia poleceń zależą od platformy i wersji oprogramowania.
Jeżeli awaria zaczęła się po podłączeniu nowego urządzenia, najrozsądniej najpierw odizolować podejrzany port. Nie należy wyłączać losowo wszystkich uplinków – można w ten sposób odciąć zarządzanie przełącznikami albo przerwać komunikację systemów produkcyjnych.
Po usunięciu fizycznej pętli trzeba sprawdzić stabilność tablic MAC, stany portów STP oraz poziom ruchu broadcastowego. Dopiero wtedy przywracać odłączone połączenia, pojedynczo obserwując reakcję sieci.
W pierwszej kolejności sprawdź, czy RSTP działa na wszystkich właściwych przełącznikach i czy Root Bridge jest wybrany świadomie. Następnie skonfiguruj porty końcowe jako edge z BPDU Guard, a miejsca podwyższonego ryzyka zabezpiecz funkcją wykrywania pętli. Najgorszy błąd to wyłączenie STP tylko dlatego, że chwilowo blokuje jeden z nadmiarowych kabli. Ten zablokowany port może właśnie chronić całą firmę przed przestojem.
FAQ – najczęstsze pytania o STP i RSTP
Czy STP zmniejsza przepustowość sieci?
STP może blokować nadmiarowe ścieżki, więc nie wykorzystuje automatycznie wszystkich fizycznych połączeń do jednoczesnego przesyłania ruchu. Jeśli celem jest sumowanie przepustowości między dwoma switchami, należy rozważyć agregację łączy, np. LACP.
Czy RSTP całkowicie eliminuje ryzyko pętli?
Nie. Błędna konfiguracja, urządzenia nieprzekazujące BPDU, problemy sprzętowe lub niezgodności między przełącznikami mogą nadal prowadzić do powstania pętli.
Czy można używać STP i RSTP w jednej sieci?
Tak, protokoły przewidują mechanizmy współpracy, ale połączenia z klasycznym STP mogą ograniczyć korzyści z szybkiej konwergencji RSTP. Trzeba sprawdzić zgodność konkretnych urządzeń.
Co oznacza port zablokowany przez BPDU Guard?
Oznacza, że chroniony interfejs otrzymał BPDU. Przed ponownym włączeniem należy ustalić, jakie urządzenie zostało podłączone i dlaczego wysyła komunikaty protokołu drzewa rozpinającego.
Czy tani, niezarządzalny switch może wywołać burzę broadcastową?
Tak. Wystarczy utworzenie pętli przez dwa połączenia. Nie należy zakładać, że switch automatycznie wykryje problem lub prawidłowo przekaże komunikaty BPDU.